Article note: #esgehtvoran! :-)

Rassismus ist derzeit wieder ein riesiges Thema. Dabei muss man ehrlich sein: Rassismus muss eigentlich immer ein Thema sein – und es ist auch ein Thema, welches unser Land betrifft. Rassismus ist auch tief in vielen Sprachen verwurzelt. Ich persönlich habe wenig Probleme damit, wenn Dinge aus dem Sprachgebrauch verschwinden, denn Sprache ist eine lebendige Sache – und mal Hand aufs Herz: Es schränkt ja nicht wirklich ein, mal diese oder jene Begrifflichkeit nicht zu nutzen, wenn sie eine Gruppe beleidigt, oder?

Gilt nicht nur für scharfe Paprikasoße, sondern auch um die heute noch gerne genutzte Begrifflichkeit in Bayern, wenn man Weizen-Cola bestellt. Ich glaube auch nicht, dass es immer zwingend böswilliger Rassismus der Menschen ist, sondern ein „ich kenne es halt nicht anders und habe es immer so gesagt“. Geht mir oft auch so, dass ich dahingehend nicht korrekt bin, aber ich habe zumindest den Willen, mich dahingehend zu bessern.

Gebessert hat sich dahingehend auch Google, doch nicht erst jetzt. Bereits seit letztem Jahr gibt es in der Dokumentation von Google Informationen darüber, wie man möglichst neutralen Code schreibt.

Aktuell hat man beispielsweise Begriffe wie Whitelist und Blacklist in Chrome ausgelöscht (bzw. wird man auslöschen), was aber nicht auf die aktuellen Proteste in den USA zurückzuführen ist, sondern generell. Da muss man sicher nicht lange denken, warum man nicht mehr an dieser Form von Begrifflichkeiten festhalten möchte, denn die „schwarze Liste“ ist durchaus negativ behaftet, was da drauf ist, darf nicht durch. Im Falle der Blacklist wird man sich dann eben mit der „Blockliste“ zufriedengeben müssen.

Die ernstgemeinte Frage an euch: Diese Assoziation von Weiß = gut und Schwarz = böse, die ist ja allgemein bekannt. Wie empfindet ihr es, wenn solche Dinge im Sprachgebrauch geändert werden? Gute Neuerung im konkreten Fall, oder doch eher absurde PR? Wo ist es sinnvoll, wo albern?

Meine Meinung habt ihr: Es ist für mich auch lange absurd gewesen, aber ich habe – wie viele andere auch – eben nichts anderes dahingehend gelernt. Dennoch bin ich weit davon entfernt, jemanden als Rassist zu bezeichnen, wenn dieser in Zukunft Begrifflichkeiten wie Black- oder Whitelist benutzt – das ist dann eher etwas für spitzfindige Detailverdreher, die gerne Dinge interpretieren oder unterstellen.

-> Zum Beitrag Google Chrome: „Schwarze Liste“ und „Weiße Liste“ verschwindet

-> Zum Blog Caschys Blog

Unser Feedsponsor:

Article note: #nice! :-)

Schema.org ist ein Format, mit dem man maschinenverständlich Inhalte auf Webseiten beschreiben kann. Beispielsweise nutze ich es auf pc-kombo, um bei den Komponentenseiten anzugeben über welche Komponente sie genau reden und um Reviews zu markieren. Google unterstützt schema.org stark und greift einige der Beschreibungen in den Suchergebnislisten auf, es gibt dafür eine Liste. Neben so praktischen Dingen wie Produktdaten und Reviews gibt es auch schlicht Artikel. Und ein Untertyp sind Blogartikel.

Damit Blogeinträge zu erweitern ist die vernünftige Alternative zu Googles AMP-Wahnsinn. Möglicherweise – zu der Einschränkung unten mehr – kann Google und auch jede andere Suchmaschine so Artikel besser darstellen, z.B. mit Artikelbild in ein oberes Artikelkarussell einbauen.

Thomas hat in seiner Linkliste einen Artikel von Lukas Murdock verlinkt, der zeigte wie Lukas Schema-Markup in seinem Blog hinzugefügt hat. Mir wurde klar: Das kann auch Serendipity automatisieren.

Bisher habe ich (in ursprung) schema.org direkt ins HTML gepackt. Das ist einer der drei möglichen Wege. Es ist dann also das Theme, das entsprechendes HTML generieren muss, das wäre schwierig gewesen. Aber das alternative JSON-LD kann in einem Rutsch bei der Artikelgenerierung erstellt werden. Diesen Vorteil hatte ich bisher nicht erkannt.

Ich habe das in ein Plugin gepackt:

serendipity_event_schema_0.1.tar.gz

Bei mir funktioniert es. Funktionieren bedeutet: Es produziert valides Schema-Markup, das den Artikel akkurat beschreibt. Z.B. für diesen Artikel:

<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "mainEntityOfPage": {
      "@type": "WebPage",
      "@id": "https://www.onli-blogging.de/1937/Schema.org-Plugin-fuer-Serendipity.html"
  },
  "headline": "Schema.org-Plugin für Serendipity",
  "image":  "/uploads/Screenshot_2020-06-05_Rich_Results_Test_-_Google_Search_Console.serendipityThumb.png",
  "datePublished": "2020-06-05T10:02:00+0000",
  "dateModified": "2020-06-05T10:27:00+0000",
  "author": {
    "@type": "Person",
    "name": "onli"
  },
  "publisher": {
    "@type": "Organization",
    "name": "onli-blogging",
    "logo": {
        "@type": "ImageObject",
        "width": 100,
        "height": 100,
        "url": "https://www.onli-blogging.de/favicon_100.png"
    }
  } 
}
</script>

Aber es gibt zwei Einschränkungen:

  1. Google gibt vor, dass ein Publisher angegeben werden muss, zusätzlich zum Autor, was bei privaten Blog natürlich Unsinn ist. Das Plugin kann diesen Abschnitt daher auch nicht komplett vorausfüllen, wir haben die notwendigen Daten nicht. Es schlägt vor, eine nach dem Autor benannte Organisation anzugeben, auch der Blogname würde passen. In der Pluginkonfiguration muss dieser Code angepasst werden, insbesondere der Link zum notwendigen Logo.
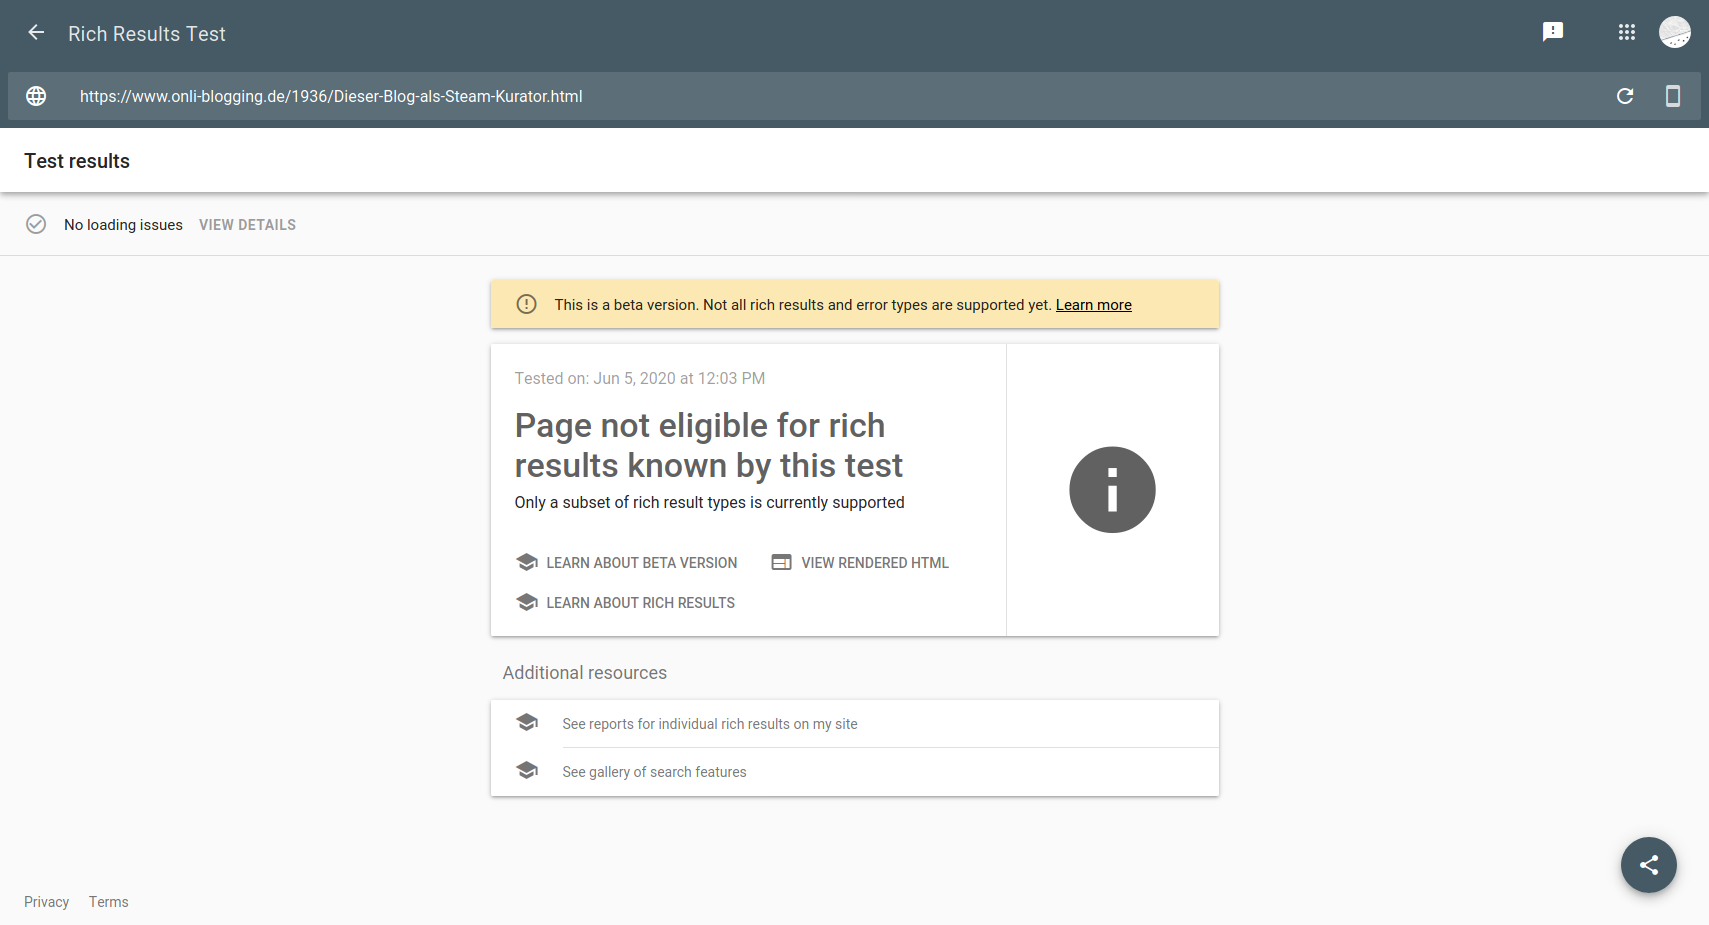
  2. Das Markup sollte mit dem Rich-Result-Tester überprüft werden. Der aber unterstützt Blogartikel nicht. Eine Erfolgsmeldung sieht daher so aus:


    Was natürlich nicht bedeutet, dass die Daten auch sinnvoll sind, was ohne Vorschau schwierig zu erkennen ist.

Es könnte also sein, dass Google zugunsten von AMP Bogartikelauszeichnungen weitestgehend ignoriert. Das sollte ein Test in unseren Blogs zeigen. Wenn es funktioniert müsste nach einer Weile Googles Searchconsole die Rich results oder ähnliches als Suchergebnisanzeige auflisten.

Nach einer Testphase – und wenn niemand über ein Plugin stolpert, das diese Aufgabe bereits erledigte, ich hatte mir nämlich eingebildet wir hätten schon ein Plugin für Schema.org gehabt – werde ich das Plugin in Spartacus hochladen.

Petition: #Brandenburg braucht ein Landesaufnahmeprogramm für die sofortige Evakuierung von mindestens 2000 besonders Schutzbedürftigen aus den EU-Elendslagern auf den griechischen Inseln. #LeaveNoOneBehind #BRBhatPlatz Petition unterschreiben: openpetition.de/!gznrk